Perché il disaster recovery è un’altra cosa
Chi gestisce servizi digitali, prima o poi pronuncia la fatidica frase: “Tranquillo, ho il backup.”
È una frase rassicurante, ma spesso nasconde un equivoco di fondo: avere una copia dei dati non significa avere un piano di disaster recovery. Sono due concetti che si sovrappongono solo in parte, e la differenza si vede proprio nel momento peggiore possibile: quando l’incidente è già avvenuto.
La realtà è che backup e disaster recovery rispondono a due domande diverse. Il backup risponde a quella più semplice: “Posso recuperare i miei dati?”
Ma anche questa domanda nasconde un’insidia. Nella mia lunga carriera, l’esperienza mi ha insegnato che un backup è un po’ come il gatto di Schrödinger: “esiste” o “non esiste” fino a quando non provi a leggerlo. Un backup che non è mai stato verificato è, in fondo, una scommessa. E proprio questa consapevolezza mi ha spinto, anni fa, a cambiare radicalmente strategia.
Il disaster recovery risponde invece a una domanda più scomoda: “In quanto tempo torno operativo, e con quali garanzie che quello che ripristino sia davvero utilizzabile?”
È un problema molto più concreto del semplice recupero dei dati. Perché avere i dati non significa necessariamente avere ancora un servizio.
Sono quindi domande diverse, ma coordinate. E la seconda richiede molto più lavoro della prima: un percorso definito, ruoli chiari (anche se il “team” è, come nel mio caso, una sola persona), un’infrastruttura di ripristino pronta all’uso e, soprattutto, una procedura ragionata e testata, non soltanto immaginata.
Un punto fondamentale di partenza è pensare al backup non come a un’unica copia, ma come a una serie di livelli con obiettivi diversi. Copie frequenti e facilmente accessibili servono per gli incidenti banali: un file cancellato per errore, una modifica sbagliata, un aggiornamento che va storto. Copie con retention più lunga e, soprattutto, isolate dalla produzione servono invece per gli scenari peggiori: per esempio un ransomware che lavora in silenzio e ha tutto il tempo di propagarsi prima di essere individuato.
Ogni livello dovrebbe avere il minimo dei permessi necessari e, dove possibile, essere organizzato in modo che sia l’infrastruttura di backup a iniziare la sincronizzazione verso la produzione, e non viceversa. In questo modo, se un attaccante riesce a compromettere il server di produzione, non ottiene automaticamente anche le credenziali necessarie per raggiungere e cancellare le copie di sicurezza. È inoltre utile, ed in alcuni contesti può essere fondamentale, implementare meccanismi capaci di utilizzare tipologia e quantità dei dati interessati dal backup per individuare anomalie nell’area di produzione. Un improvviso cambiamento radicale nella quantità o nella natura dei dati da salvare può essere esso stesso un segnale di qualcosa che non va.
Ma questo è solo il primo passo: in caso di incidente serio, i soli dati non bastano a ritornare operativi.
Qui arriva il punto centrale: serve un piano di recupero in grado di far ripartire un’infrastruttura da zero, o comunque da una situazione il più possibile vicina allo zero, e che sia stato verificato sul campo: una procedura di disaster recovery che non è mai stata testata è, nella pratica, solo una teoria. Il ripristino “a freddo” nasconde sempre delle sorprese: uno script che si aspettava un percorso diverso, una dipendenza dimenticata, un pacchetto che non è più disponibile, un certificato scaduto, una configurazione che nessuno ricordava di dover ripristinare. E poi c’è il tempo di ripristino, spesso stimato “a occhio” e quasi sempre radicalmente più ottimistico di quello reale.
L’unico modo per saperlo prima che succeda davvero è simulare il disastro quando non c’è fretta, non quando il servizio è già giù e i clienti stanno scrivendo.
Testare periodicamente il disaster recovery significa anche misurare concretamente il tempo necessario al ripristino, non semplicemente stimarlo. Sapere che l’infrastruttura torna operativa in un tempo definito e verificato sul campo è una garanzia completamente diversa da un generico dovrebbe funzionare.
La procedura di emergenza conta, in definitiva, quasi quanto i dati che abbiamo salvato.
Avere il backup è una condizione necessaria. Avere una procedura di disaster recovery collaudata, con test periodici, tempi misurati e ruoli chiari è ciò che permette di trasformare quelle copie in una reale capacità di recupero.
La differenza la si paga prima del disastro, in tempo, organizzazione e risorse. Ma è un investimento che costa infinitamente meno del dover improvvisare tutto quando il disastro è già arrivato e l’orologio continua a ticchettare con l’IT fermo.
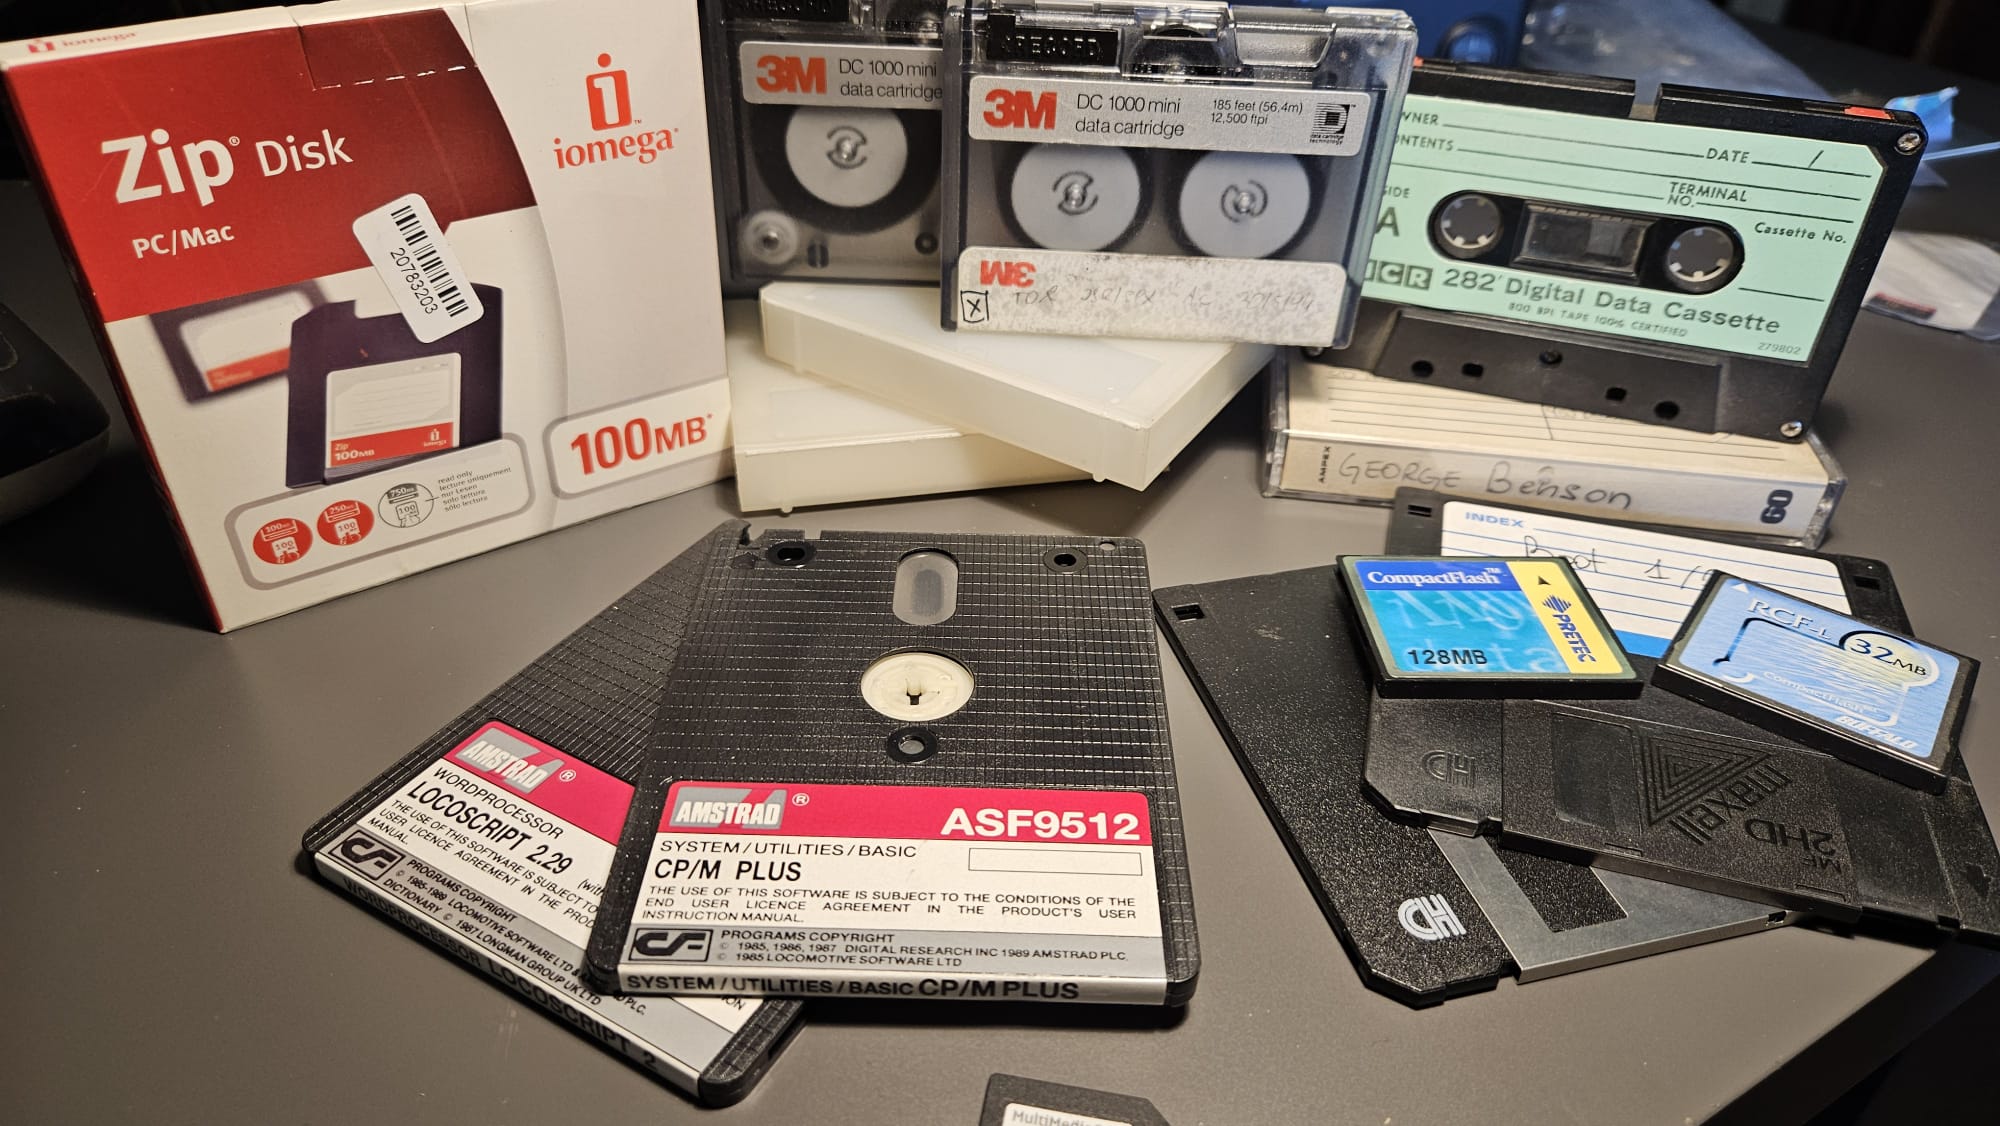
Nella foto del titolo una piccola raccolta archeologia del backup: floppy, Zip, cartucce a nastro, CompactFlash e altri miei reperti dell’epoca in cui i megabyte erano ancora una quantità rispettabile. E sì, quella che sembra una musicassetta è in realtà una Digital Data Cassette conforme agli standard ECMA: praticamente sconosciuta ai più, ma perfettamente seria per l’epoca (1971). La capacità di memoria spazia dai 80kB della cassetta ECMA ai 100Mbyte dello Zip. Fra i tanti sistemi di backup che ho utilizzato nella mia carriera vale la pena citarne uno alquanto particolare, la videocassetta VHS: interfacce specializzate (la più famosa era la mirror della Corvus, ma ne proliferarono tante) consentivano di registrare su un normale videoregistratore domestico sino a circa 100MByte di dati.
Abbiamo cambiato supporti, capacità e tecnologie – per fortuna, ma il backup continua a essere il backup. E continua a servire quando meno ce lo aspettiamo.