 Nove giorni di fragilità
In nove giorni si sono susseguiti vari eventi, molto diversi per origine, che hanno messo in evidenza la fragilità di sistemi da cui dipendiamo ogni giorno.
Il 5 novembre una serie di allarmi bomba ha colpito 18 voli europei, almeno sei dei quali da o per l’Italia.
L’11 novembre una singola mail ha raggiunto migliaia di scuole italiane (circa 6.300 secondo le ricostruzioni giornalistiche), provocando evacuazioni in diverse città.
Da giovedì 12 novembre Outlook e Teams sono rimasti fuori uso per quasi un giorno, con segnalazioni da 74 Paesi, Italia compresa.
Il 13 novembre la FAA ha sospeso per oltre quattro ore le partenze dagli aeroporti americani.
Nel dibattito pubblico torna sempre la stessa domanda: quanto costa, quanto dobbiamo spendere.
Ma è la domanda giusta?.
L’ordine sbagliato delle domande
Continuiamo a discutere di quanti soldi servano, di quali tecnologie acquistare, di quali risorse destinare alle strutture preposte, ma raramente ci chiediamo prima quale sistema vogliamo costruire e con quali professionalità.
L’ordine, secondo me, dovrebbe essere un altro: prima le competenze, poi l’organizzazione, infine le risorse economiche. La sicurezza non si risolve acquistando tecnologia o aumentando i budget. Servono persone con competenze reali, percorsi professionali capaci di attrarle e trattenerle, strutture adeguate e una chiara distribuzione delle responsabilità. Servono capacità di analisi, prevenzione, gestione degli incidenti e coordinamento tra le componenti pubbliche e private.
Solo dopo ha senso stabilire quanto investire e dove. Non perché i soldi contino poco, ma perché dovrebbero essere la conseguenza di un progetto organizzativo e operativo, non il punto di partenza della discussione. Il rischio è investire molto, magari moltissimo, senza aver costruito prima la capacità di utilizzare efficacemente quelle risorse.
La cronaca del 13 novembre ne è un esempio. Il segretario ai Trasporti americano ha indicato nell’obsolescenza delle infrastrutture una delle ragioni del problema e ha annunciato la necessità di importanti investimenti per modernizzarle. È una ricostruzione che dovrà essere verificata, ma il punto interessante è un altro: prima ancora di discutere di nuove tecnologie, emerge il problema delle infrastrutture sulle quali quelle tecnologie devono funzionare.
Tre eventi diversi, un filo comune
Non sono la stessa storia, ed è bene dirlo.
Outlook è un problema di un’infrastruttura cloud centralizzata, utilizzata da centinaia di milioni di persone. Microsoft ha parlato di carico elevato e, secondo gli aggiornamenti diffusi, alcuni server non superavano i controlli automatici di stato e venivano esclusi dal servizio. L’azienda ha escluso un attacco informatico, ma l’incidente è troppo recente per avere disponibile un rapporto tecnico definitivo.
Il blocco dei voli americani è stato provocato da un problema di comunicazione e di stabilità dei sistemi radar che ha interessato i centri di controllo del traffico aereo e le strutture di controllo terminale. La FAA ha disposto il blocco delle partenze per ragioni precauzionali, in presenza di dati radar e comunicazioni non sufficientemente affidabili. Anche in questo caso non si tratta, secondo le prime indicazioni, di un attacco informatico, e le cause tecniche precise dovranno essere accertate. Le autorità stanno esaminando, tra l’altro, possibili incompatibilità tra le vecchie apparecchiature e quelle nuove in corso di installazione.
Gli allarmi bomba non sono un guasto: sono messaggi di posta elettronica inviati in serie, a costo quasi nullo, che hanno costretto a evacuare scuole e a deviare aerei, con tanto di intervento di caccia militari, anche se nessuna delle minacce si è poi rivelata fondata.
Il filo comune non è la causa, ma le conseguenze: sistemi dai quali dipendiamo, spesso centralizzati, che operano senza una alternativa immediatamente disponibile quando qualcosa si ferma. Non sono eventi banali: sono relativamente semplici da innescare o da subire, ma molto costosi da gestire.
Sicuro non vuol dire senza incidenti
Dobbiamo smettere di identificare la sicurezza con l’assenza di incidenti: un sistema davvero sicuro è un sistema resiliente: assorbe un attacco o un guasto, ne limita gli effetti, reagisce e continua a erogare i servizi essenziali, magari a capacità ridotta. Non evita necessariamente il guasto, ma al più degrada progressivamente, senza perdere tutte le proprie funzioni essenziali.
E la resilienza non si compra: si costruisce con competenze, organizzazione, procedure e investimenti coerenti con questo obiettivo. E soprattutto si prova: chi, come me, fa radio da una vita lo sa bene che una rete di emergenza funziona perché è semplice, ridondante e viene messa alla prova prima che serva.
Il protocollo e il problema della scala
Il 13 novembre il Viminale ha inviato a prefetti e questori una circolare di quattro pagine. Il criterio centrale è che una minaccia manifestamente seriale, cioè costituita da messaggi identici o sostanzialmente analoghi, con la stessa provenienza e indirizzati indiscriminatamente a una pluralità di destinatari, va considerata inattendibile, salvo la presenza di ulteriori elementi concreti di rischio.
La circolare precisa che il questore può disporre verifiche e misure di sicurezza e, solo quando lo ritiene necessario, proporre al prefetto l’evacuazione. Prevede inoltre che il Centro Situazioni del Dipartimento della pubblica sicurezza, operativo 24 ore su 24, curi il raccordo informativo con gli uffici territoriali, favorendo la condivisione delle segnalazioni e degli elementi utili a valutarne l’attendibilità.
È un criterio ragionevole, e l’esistenza di un coordinamento centrale è certamente positiva. Ma rimane una questione organizzativa che per me andrebbe valutata meglio.
La serialità è una proprietà che un singolo preside non può vedere: riceve la propria mail e non ha necessariamente modo di sapere che la stessa comunicazione è arrivata ad altre migliaia di istituti. Per avere il quadro d’insieme deve ricevere informazioni da una struttura centrale. La domanda, quindi, è se il raccordo previsto sia sufficientemente rapido, capillare e ridondante da raggiungere tutti gli interessati contemporaneamente.
Un dirigente che risponde della sicurezza di centinaia di minori, senza informazioni tempestive e senza indicazioni operative, ha un comportamento comprensibile e difficilmente contestabile: evacuare. Il risultato può essere una gestione a macchia di leopardo, con la stessa comunicazione che produce reazioni diverse caso per caso.
In termini tecnici è la differenza tra push e pull. Se ogni nodo deve interrogare il centro per sapere cosa fare, il centro rischia di diventare il collo di bottiglia. Sarebbe preferibile, invece, che il centro potesse distribuire simultaneamente le informazioni e le indicazioni operative, attraverso canali ridondanti, con procedure già definite e sperimentate.
Non so se un sistema di questo tipo esista già e sia stato effettivamente provato su questa scala. È una delle domande a cui mi piacerebbe conoscere la risposta. Perché, se le procedure per i falsi allarmi esistevano già, come sostiene il ministro, il problema non era necessariamente la loro assenza, ma la capacità di applicarle efficacemente a migliaia di destinatari contemporaneamente. E’ il classico problema di scala, che noi informatici conosciamo bene, ma che è spesso sottovalutato in sede operativa.
Il piano B, e anche il C e il D
La società di oggi ha una fiducia quasi incondizionata nella tecnologia, che spesso porta a considerarla implicitamente perfetta: così non ci si premunisce contro eventi forse poco plausibili, ma possibili, con effetti potenzialmente molto gravi anche quando l’origine è apparentemente banale. A volte ciò che sembra improbabile accade, soprattutto quando si moltiplicano le occasioni perché accada.
Un giorno senza posta elettronica ha messo in difficoltà aziende e amministrazioni. Ma se un’organizzazione perdesse l’intero contenuto delle proprie caselle? Alzi la mano chi ha un backup della posta e, soprattutto, chi ha mai provato a ripristinarlo.
Manchiamo troppo spesso di piani B e, per le attività più importanti, servirebbero anche il C e il D. Siamo spesso capaci di reagire a evento accaduto, ma non sempre di prepararci prima, con ritardo e improvvisazione che diventano parte del problema.
C’è anche un effetto meno evidente: quando una tecnologia funziona bene per molto tempo, smettiamo progressivamente di mantenere le competenze e le procedure necessarie per farne a meno. Le scopriamo mancanti proprio nel momento in cui servirebbero.
Applicare su larga scala, ma su quali basi
Il 16 settembre, nel suo discorso sullo Stato dell’Unione, Ursula von der Leyen ha sostenuto che l’Europa non deve necessariamente sviluppare in prima persona le tecnologie di frontiera dell’intelligenza artificiale per ricavarne il massimo valore. La chiave, nelle sue parole, è portare l’intelligenza artificiale dallo schermo all’economia reale: fabbriche, reparti ospedalieri, agricoltura di precisione, reti energetiche, guida autonoma e difesa.
Sul principio posso essere d’accordo. Non è necessario sviluppare autonomamente ogni tecnologia per saperla utilizzare e trarne vantaggio. La stessa von der Leyen ha però riconosciuto la necessità di mantenere capacità tecnologiche europee proprie, soprattutto per la sicurezza nazionale.
È una distinzione importante: non occorre necessariamente costruire tutto, ma bisogna essere in grado di comprendere ciò che si utilizza, valutarne i limiti, governarlo e, quando necessario, farne a meno.
Tre degli ambiti citati, ospedali, reti energetiche e difesa, sono infrastrutture critiche, cioè proprio i luoghi in cui un guasto può avere conseguenze particolarmente gravi. Applicare su larga scala una tecnologia che non siamo in grado di governare fino in fondo, senza competenze adeguate, senza piani alternativi e senza averla provata sotto stress, non riduce la fragilità: rischia di amplificarla.
Il problema, quindi, non è essere favorevoli o contrari all’innovazione. È capire che l’innovazione non può prescindere dalla conoscenza delle infrastrutture sulle quali viene applicata. Si tende a guardare la tecnologia nuova, mentre spesso la fragilità è nella base, nelle dipendenze e nelle procedure che la sostengono.
Cosa chiedersi, da oggi
La questione non è soltanto quanto spendiamo, ma se sappiamo davvero cosa vogliamo realizzare con quei soldi. Prima di parlare di cifre, ci sono alcune domande che ciascuno, nella propria organizzazione, dovrebbe porsi, e questo elenco è giusto un esempio:
- Ho il backup della posta elettronica e ho mai provato a ripristinarlo?
- Se per un giorno non funzionano posta, gestionale o telefoni, so cosa fare?
- Ho un canale alternativo per raggiungere colleghi, clienti e fornitori?
- Quando arriva una segnalazione che non so verificare, so chi deve decidere e attraverso quali procedure?
- Se sono colpito da un ransomware come risolvo la situazione?
- Chi, nella mia organizzazione, ha le competenze per affrontare un incidente? E queste competenze sono mai state messe alla prova?
Progresso e fiducia nella tecnologia non sono il problema. Il problema è inseguirli senza comprenderli e senza attrezzarsi per governarli.
Una società moderna dovrebbe essere in grado di fare entrambe le cose.
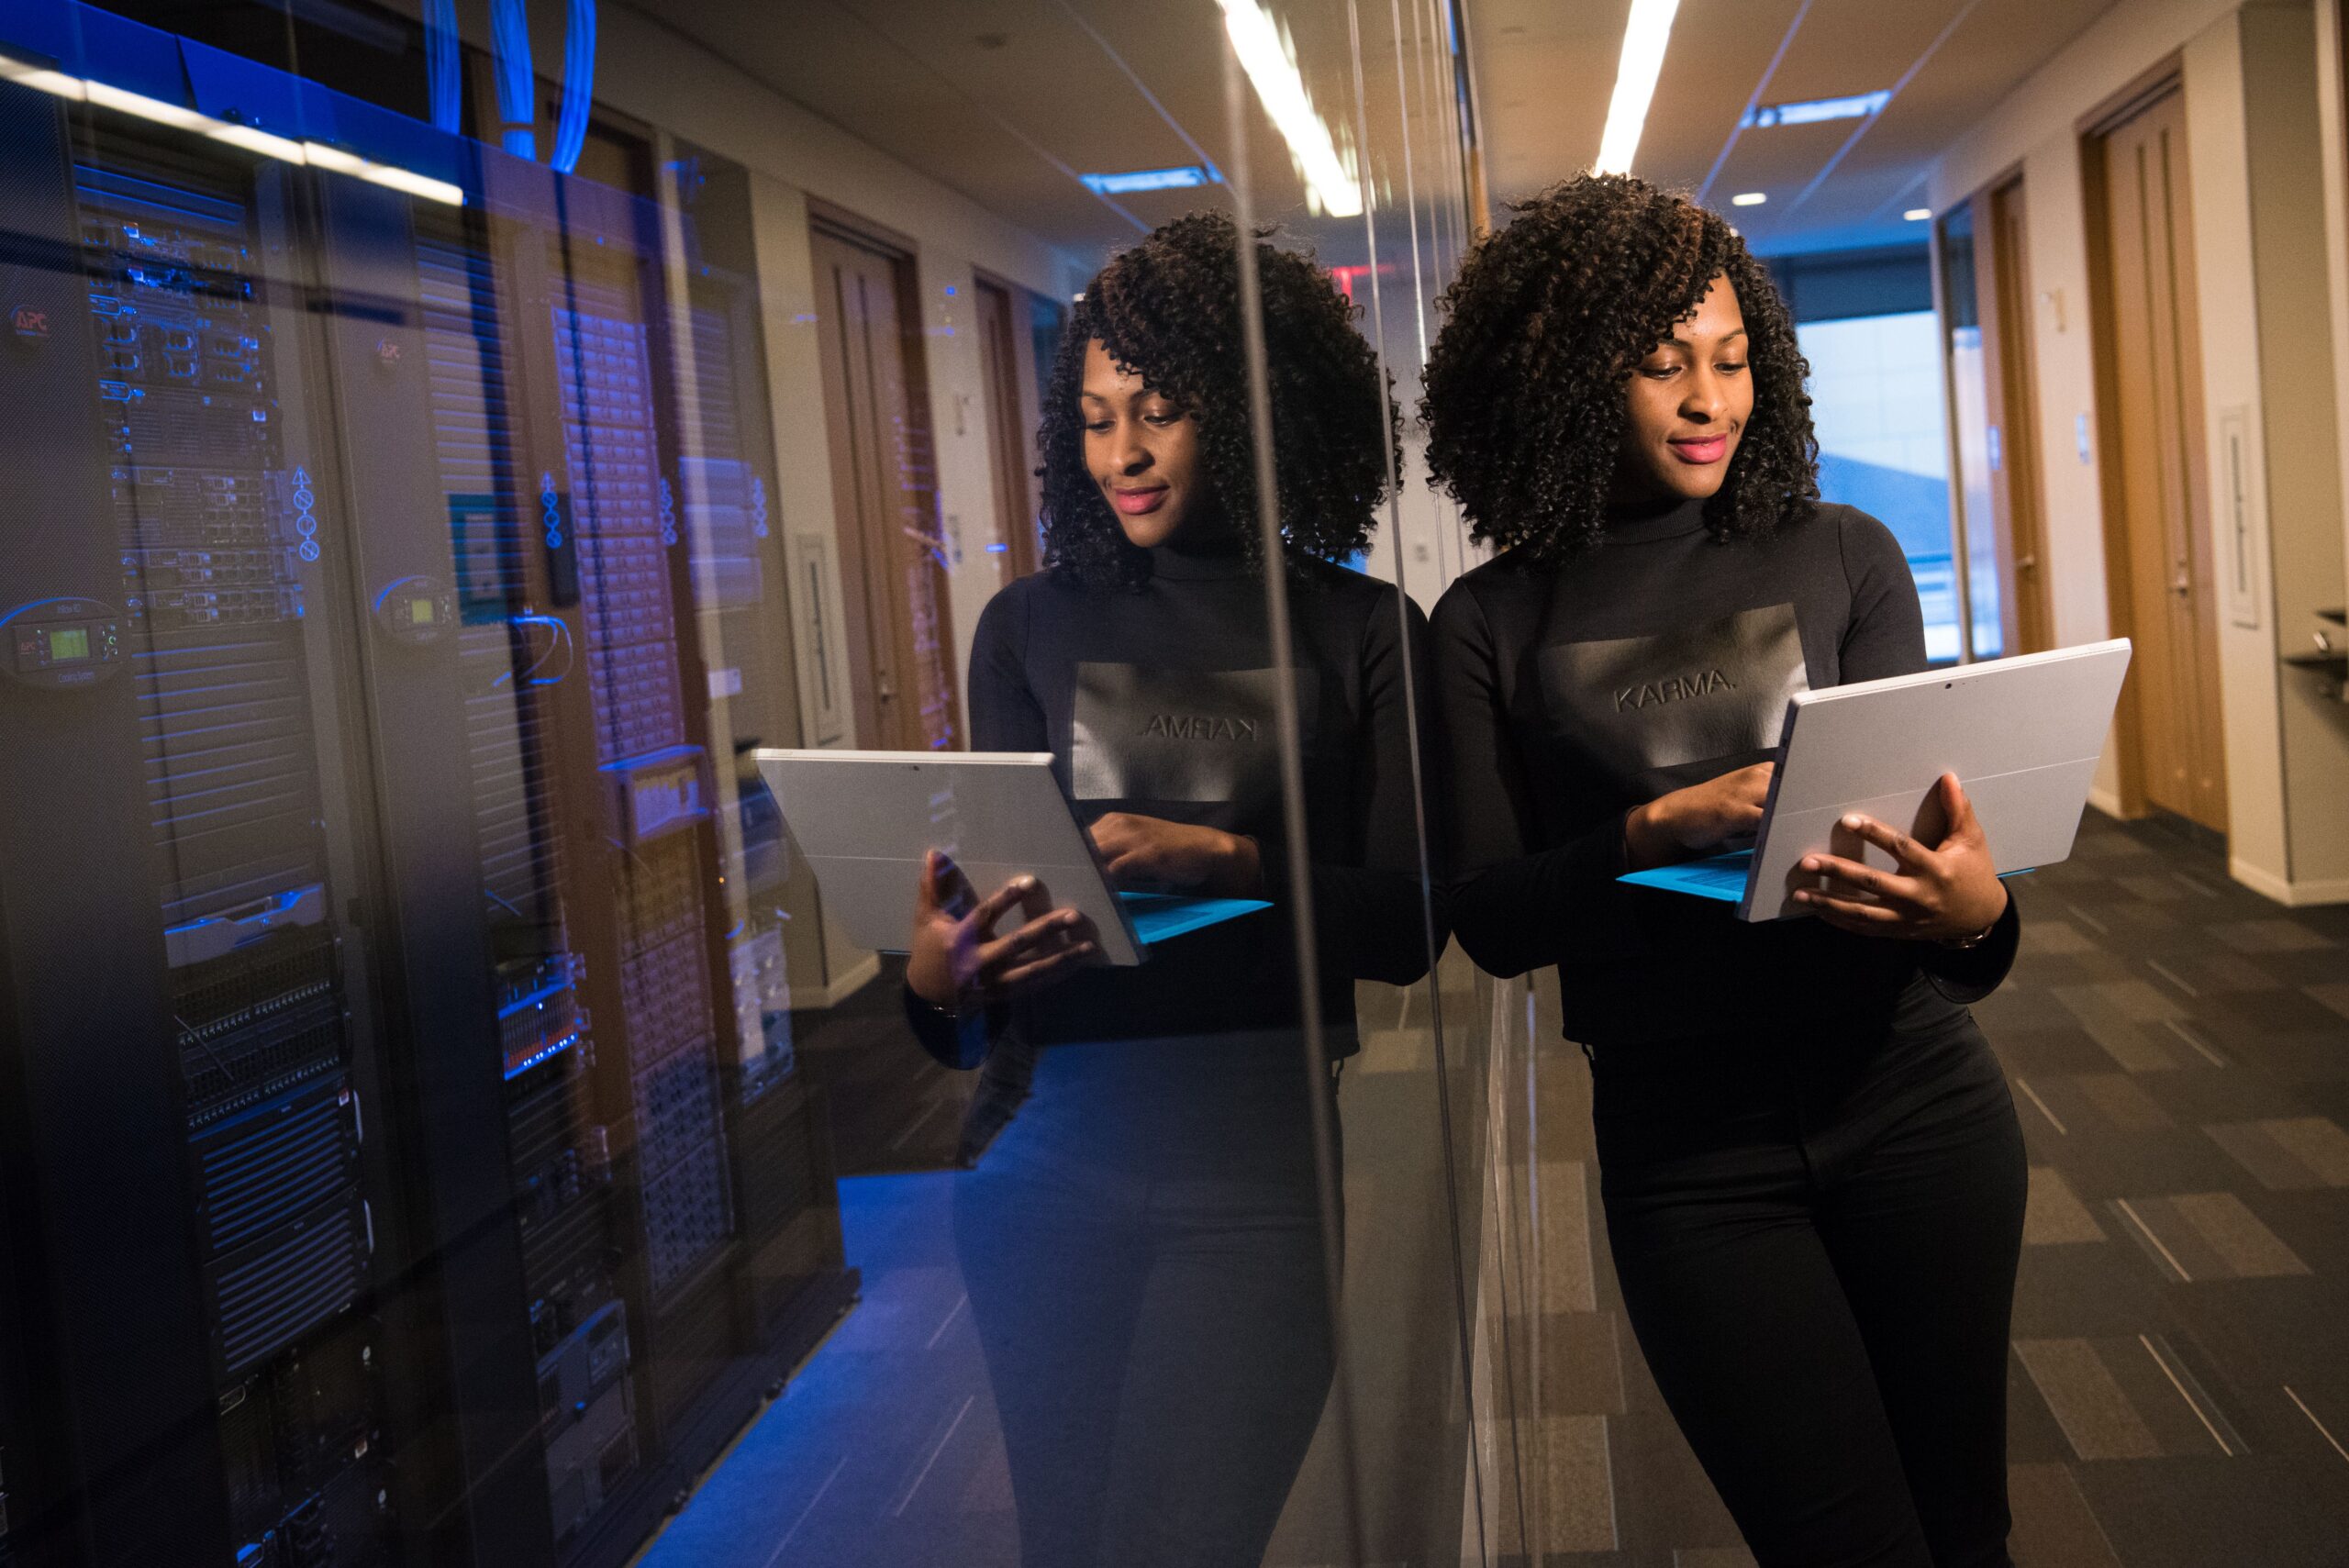
La foto del titolo è di Christina Morillo da Pixabay. Rappresenta bene un’idea che attraversa tutto il post: prima della tecnologia vengono le persone, le loro competenze e la loro capacità di usarla e governarla. E anche perché credo sia ora di sfatare un luogo comune ancora troppo diffuso: l’informatica non è, e non deve essere considerata, un mondo prevalentemente maschile.